

Семинар #3 · 18 сентября 2026 · Регулярный AI Native Seminar · 5 докладов
Распределённый ИИ-Университет
Три слоя ИИ-Университета и экономика токенов; геймификация и китайские кейсы ИИ в образовании; локальная NotebookLM-платформа; ИИ-куратор проектных команд; платформа AI Native University.
Полная запись семинара «Распределённый ИИ-Университет»
Сессия без вступительной преамбулы и длинных простоев.
Распределённый ИИ-Университет: три слоя и экономика токенов
Ведущий семинара
Модель трёх слоёв ИИ-Университета (инфраструктурный, педагогический, онтологический), новые роли в образовании и разбор бюджета на токены.
- Три слоя: инфраструктурный (деньги/железо), педагогический (как меняются подходы), онтологический (картина мира, роль агентных систем).
- Риск «мясных прокси»: человек рискует стать интерфейсом между двумя ИИ вместо интерфейса к самой работе; предложены роли — постановщик задачи, решающий студент, внешний контролёр процесса.
- Пример — курс «Оптимизация радиотехнических систем»: преподаватель-модератор, студенты и ИИ совместно решают «нерешаемую» задачу.
- Экономика: курс «грамотность» (~4500 студентов) — 1,3 млрд токенов в базовом режиме, ~10 млрд с персональным ИИ-тьютором; бюджет ~15 млн ₽ на токены, 25–30 млн ₽ с сопровождением людьми; одна GPU (~1,5–2 млн ₽) держит ~30 студентов; подписочные токены дороже прямой закупки мощностей в 10–20 раз.
- Распределённая модель по специализациям: ТюмГУ — «фабрика цифровых профессоров», УрФУ/ИОТ — синтез тьюторских данных, МФТИ — фронтир; инфраструктурно — Яндекс и Сбер плюс локальный инференс; внешние API не используются из-за требований к данным (152-ФЗ).
- Онтологический слой: единая непротиворечивая база знаний и ценностей для разных агентов (~70% базы общее), вопросы этики и системы принятия решений.
- Как избежать вендорской зависимости от Яндекса/Сбера и обеспечить объём токенов при масштабировании с 4500 до десятков тысяч студентов?
- Подтверждается ли тезис о ежегодном 10-кратном удешевлении токенов?
- Как распределять личные и общие токен-лимиты студентов, чтобы не создавать цифрового неравенства?
- Что конкретно должен содержать онтологический слой — сущности, механизмы поощрения/наказания, этика?
Цифровая дидактика и геймификация; китайские кейсы ИИ в образовании
Докладчик, Гуманитарный институт (УГИ)
Разграничение геймификации и game-based learning, критика модели PBL в пользу внутренней мотивации, обзор китайских и западных кейсов ИИ в образовании.
- Геймификация — игровые элементы вне игры; game-based learning — готовые игры или их дизайн под обучение. Модель PBL (баллы/бейджи/лидерборды) опирается на внешнюю мотивацию; современные фреймворки делают акцент на внутренней.
- Китайские кейсы: ИИ-коуч переговоров (развивает мышление, но не заменяет живое взаимодействие → гибрид), генеративный ИИ для реформы программ, анализ тысяч комментариев (финальный вывод — за человеком), предиктивная система риска несдачи, модель «Dual Spiral» (диалог с ИИ переплетается с живым диалогом ученик–учитель).
- Вывод: ИИ трансформирует, но не отменяет геймификацию и game-based learning — забирает рутину, творчество остаётся за человеком; китайские кейсы дают масштаб и скорость, западные — методологическую глубину.
- Что внедрять в первую очередь при ограниченных ресурсах? (сначала протестировать типологию мотивации аудитории; базовая PBL работает всегда хотя бы по минимуму)
- Возможна ли динамическая «нарраторная» адаптация сложности под студента — и какова цена участия методистов?
- Насколько игровые подходы реально практикуются как норма, а не декларируются энтузиастами?
Локальная NotebookLM-платформа (Open Notebook) УрФУ
Докладчик, команда локального ИИ-инференса
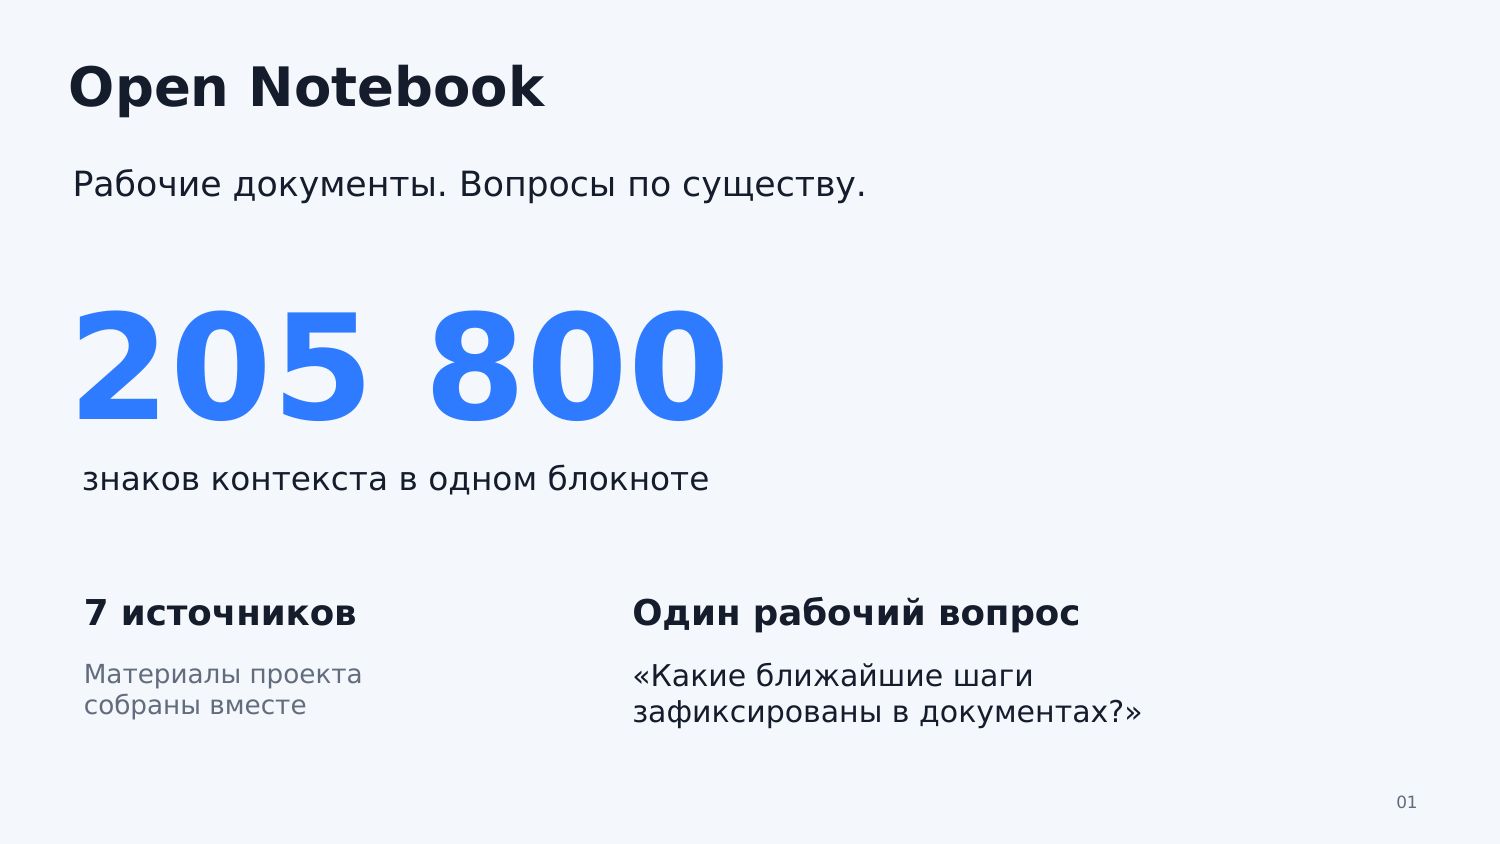
Полностью локальная платформа на базе доработанного open-source Open Notebook: данные не покидают контур УрФУ.
- Изначально — для анализа закрытых данных программы развития; отсюда требование полной локальности.
- Функции: ~1800 контекстов и 7+ источников на блокнот, ИИ-ассистент инструкций, диалог с блокнотом, HTML-отчёты и протоколы, извлечение ключевых идей, генерация аудио-подкаста по содержимому.
- Семейство локальных моделей под разные задачи; узкое место — одна мощная видеокарта (~30 пользователей одновременно).
- Планируется публикация блокнота как верифицированной базы знаний (по типу маркетплейса).
- Кому принадлежат авторские права на загруженные материалы и блокноты; как защититься от загрузки чужого без разрешения при встраивании в курсы?
- Как разграничивать доступ к чувствительным базам (юридические/религиоведческие материалы, персональные данные)?
- Строить ли верифицированные базы знаний по кафедрам как отдельный продукт (три слоя: образовательный, организационный, научный)?
- Как снять бюрократию и отсутствие стимулов, мешающие преподавателям загружать материалы?
ИИ-куратор проектных команд
Докладчик, Институт фундаментального образования
ИИ-ассистент куратора проектного обучения: отслеживает снижение вовлечённости команд и снимает формальную нагрузку, не подменяя куратора.
- Проблема: куратор ведёт 5–8 (до ~15) команд; вовлечённость падает к 4–5 неделе; обратная связь собирается поздно; существующий бот только реактивен.
- Решение: ассистент отслеживает 6 типов сигналов снижения вовлечённости, ведёт «сократовский диалог», контролирует сроки, делает предварительный норм-контроль; не ставит оценок, не делает работу за команду, шлёт ≤2 проактивных сообщения в неделю.
- Статус: документация и локальная реализация готовы, есть грант облака; пилот на 3–5 команд с начала октября 2026, сравнение групп «с ассистентом / без» — в 2027.
- Ассистент встраивается туда, где команды реально работают (браузерный плагин + Telegram), а не как модуль внутри Team Project.
- Не сократит ли ассистент содержательную коммуникацию команды и куратора? (цель — забрать только формальную нагрузку)
- Не решается ли проблема вовлечённости кураторов кратным повышением оплаты, а не инструментом?
- Как строить ролевую модель по воркспейсам и какие метрики вовлечённости собирать?
Платформа AI Native University
Докладчик, команда платформы
Единая точка входа для студентов, преподавателей и сотрудников (принцип Госуслуг): обучение, сервисный слой и работа сотрудника на естественном языке.
- Три части: обучение (геймификация, интерактивные курсы), сервисный слой (тьюторы, чаты, БРС, деканат — через одно окно чата), работа сотрудника (управление процессами через «ноутбук LM» и конструктор мультиагентных сценариев).
- Цикл курса: вход в проблемную ситуацию → симулятор/решение → рефлексия (5–10 мин), артефакт уходит в аналитику; самый сложный курс — «Оптимизация радиотехнических устройств» (нужен спец-симулятор).
- Платформа не пишет свою LLM, а маршрутизирует задачи между моделями (локальный инференс для внутренних данных, YandexGPT для генерации контента).
- Почему не дорабатывать Moodle/OpenEdu: плагинная архитектура legacy не даёт сквозного агента с общим контекстным окном и интегрированной аналитикой.
- Объединять ли модуль e-tutor с ИИ-куратором проектных команд в единый модуль на весь образовательный процесс?
- Что делать с БРС, нефункциональной на больших группах — кто владелец и срок исправления?
- Как формализовать роль методиста при появлении ИИ-помощника согласования курсов?
Итоги и решения
Итог: инфраструктурный слой (локальные LLM + база знаний УрФУ) → два сервиса поверх — платформа AI Native University и управленческий Rector Vision. Отдельно отмечены идея верифицированной базы знаний ППС и необходимость «смысловой прослойки» (мотивационный дизайн), без которой агенты рискуют остаться набором несвязанных частей.
Открытый доступ. Материалы обезличены: имена участников в разборах заменены на роли.